『イラストで学ぶ 自然言語処理』という本を出版することになった。
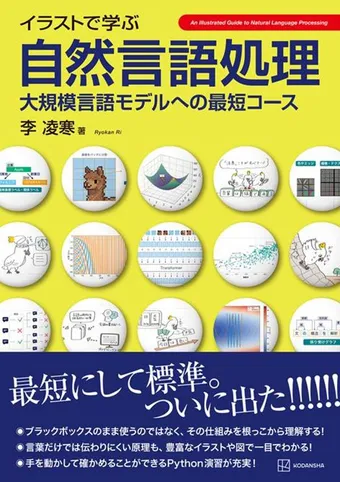
大学で自然言語処理(NLP)を6年間研究し、卒業後は企業で LLM 開発に4年間携わった。気づけば、この分野に関わって10年になる。そこで得た知見を、なるべく手短に伝えたいと思って書いた本だ。
ただ、執筆中も書き上げてからも、うっすら思ってしまうことがある。
「これって意味あるの?」
2020年、指導教員だった鶴岡慶雅先生が、学会誌に「最高の文章」という巻頭言を寄せていた。読者の持つ知識に合わせて最適化された文章こそが「最高の文章」であり、自分に最適化された「最高の教科書」で勉強できたら、学習効率は10倍どころではない、という話だ。
当時の私は「あったら嬉しいけど、ドラえもんと同じくらい遠い話だな」と思った。
それから数年で、状況はずいぶん変わった。
機械学習について学ぶとき、ChatGPT に「数式は苦手なのでコードで」と添えれば、そのとおりに説明してくれる。Claude に「インタラクティブな教材を」と頼めば、いじりながら学べる教材が出てくる。
Gemini に聞いてみたら、二つの回答のどちらがよいか尋ねられた。
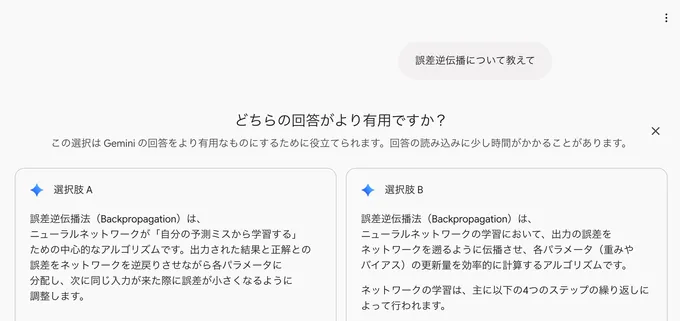
教えてもらいに来たのに、こちらが採点する側である。少々頼りない教科書だが…鶴岡先生の言う「最高の教科書」にずいぶん近づいているのではないか。
一人ひとりの知識や疑問に合わせて説明を変えてくれる「最高の教科書」があるのなら、誰が開いても同じことしか言わない本を、わざわざ書く意味などあるのだろうか。
LLM はどれくらい教えるのがうまいのか
実は本書の執筆に際しても、AI に説明文を書かせてみた。
「Transformer エンコーダの説明を生成してみて」と頼んだところ、かなり整った文章が出てきた。事実関係もおおむね正確で、専門用語の使い方にも違和感はない。これだけ書けるなら、教科書の執筆も任せられるのではないかと思った。
ところが、じっくり読んでみると、どうにも惜しい。
具体例を交えて説明してほしいところで抽象的な説明が続いたり、さらっと流してほしいところで妙に詳しくなったりする。例えば、論文を参考にした説明では、唐突に「XX は 74.8% の精度を達成し、YY に対して 6.1 ポイント改善した」といった数値が登場する。間違った情報ではないが、そこまでの詳細は求めていない。
何をどのくらい説明するかの加減が、思っていた以上に難しいようだ。
結局、本書では、文献調査や文章の校正、数式の TeX コードの生成などに LLM を活用した。説明する内容や情報の粒度は自分で考え、書いた文章を整えてもらう、という使い方が多かった。
こうした「惜しさ」は、単に私の好みの問題なのだろうか。
気になって研究を調べてみると、教材の生成能力を人間と比較した実験がいくつか見つかった。
例えば、2026年に発表された研究では、GPT-5.2、Claude Sonnet 4.6、Gemini 3.1 Pro など5つのモデルに、心不全の患者向けの説明を生成させ、医療の専門家が書いた教材と比較している。
その結果、情報の品質、読みやすさ、具体性、正確性、安全性といった指標で、人間の教材が高く評価された。
ただし、この実験では、LLM に一度だけ回答を生成させている。人間の著者がするように、内容を吟味し、推敲を重ねたわけではない。
実際、複数の LLM エージェントに役割を分担させて教材を制作すると、単一のエージェントより品質が改善することを示した研究もある。
モデルの進歩は速い。過去の研究は、あくまで過去のモデルと方法論によるものだ。すでに、人間に匹敵する説明ができる場面もあり、今後さらに増えていくだろう。
それに、説明文を生成するだけでは、「最高の教科書」にはまだ遠い。学習者に応じて教材の形を変える、インタラクティブなものならどうだろうか。
2026年、Google の研究チームが、高校生60人を対象に、従来の教科書と、AI を活用した学習サービス「Learn Your Way」を比較した研究を発表している。
Learn Your Way は、既存の教科書をもとに、学習者の知識や興味に合わせて説明を書き換え、図解やクイズなども提供するものだ。
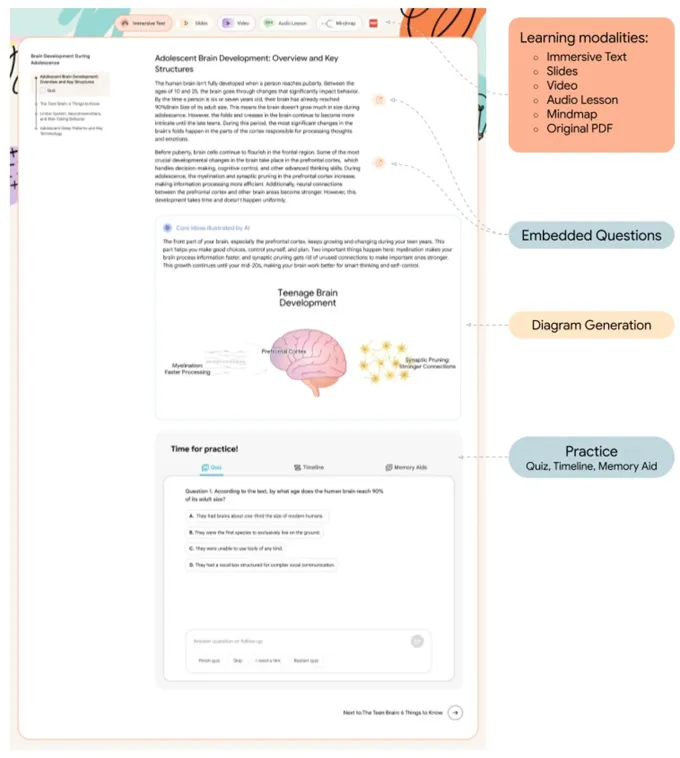
実験では、同じ「脳の発達」に関する教科書の章を、通常の教科書の PDF で学ぶグループと Learn Your Way で学ぶグループに分けた。
結果は Learn Your Way の勝ちで、通常の教科書で学んだグループより、直後と数日後のどちらのテストでも成績がよかった。
著者は効果が見られた理由として、3つの要因を考察している。
- 説明を小さな単位に分けたこと。長い章を一気に読むのではなく、短い説明を読んで理解を確認する構成になっている。
- クイズとフィードバックがあること。LLM で生成された教材では、クイズで理解を確認できる。
- 複数の表現形式から自分で選べること。文章、図、音声など、自分の目的に合う形式を選択でき、理解や学習意欲に寄与した可能性がある。
LLM によって「読む」ことにとどまらない学習体験が実現され、それが学習効果を高めているようだ。
こうしたインタラクティブな学習は、すでに巷の AI チャットサービスで可能になっている。ChatGPT、Claude、Gemini はいずれも、学習者の理解を確かめながら教えるための機能を提供している。
ここまで調べてみたところ、教科書を書く意味を考えていたはずが、あまり安心できない材料のほうが集まってしまった…
人間が書く意味は、情報の重み付けにある?
もちろん、今の AI にも課題はある。誤った情報を生成する可能性は残っているし、自分に何が必要なのかをうまく AI に伝えられない人もいる。そうした中で、著者や編集者が内容を検証し、一冊にまとめた教科書には、一定の安心感があるだろう。
ただ、AI は今後も進歩する。人間の知的作業なら何でも高度に代替できてしまう AI が出来たとき、それでも人間が教科書を書く意味は残るだろうか。
私は、「教科書を書く」という行為の最適な形が変わるかもしれないが、そこに人間が介在する意味はあると思っている。その理由を説明するために、少し昔の話をしたい。
学生時代、ニューラルネットワークの学習を速くしようと、計算を担う GPU を1枚から2枚に増やしたことがある。
そしたらかえって遅くなった。
GPU の中身も、分散学習のボトルネックも理解しておらず、デバッグする気骨もなかったので、そのまま放置し、結局 GPU 1枚の学習で大学院時代を乗り切った。ちなみに、初代 GPT の事前学習には GPU を8枚使っていたというので、私のようなやつは逆立ちしても GPT を発明することはなかっただろう。
当時の私でも読めるような、GPU や分散学習の基本的な解説があったらなぁ、と思う。それもあって、本書では、分散学習に一章を割いた1。
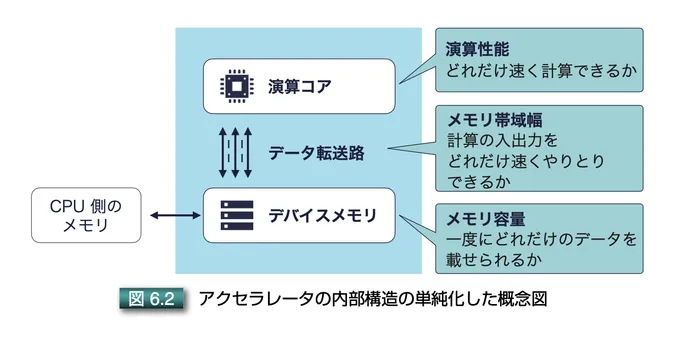
学生の頃の私にもわかるように、なるべく基本から丁寧に解説したつもりだ。NLP の教科書では珍しいトピックかもしれないが、私から見える景色では、NLP を支えるハードウェアの話が、一章を割くくらいの一大トピックに見えている。
これから NLP を学ぶ人には、巨大な言語データとモデルのパラメータが、計算機上でどのように処理されているのかも伝えておきたい。
それを知ることは、LLM がどのように実現されたのかという根本的な理解を助けるし、ライブラリを使う際に遭遇するエラーや設定オプションに対処する力にもつながる。そんな実感が本書には反映されている。
こうした情報の重み付けは、章立ての話だけではない。
例えば、強化学習の箇所では、解説したいイケてるアルゴリズムが山ほどあった。だが、私が解説して楽しいものを全部入れると、入門書ではなくなる。
そこで、個々のアルゴリズムには深入りせず、その仕組みを理解するための基本的な見方に絞った。例えば、LLM の強化学習で使われる方策勾配法を、「自分で生成した回答を、報酬に応じて重み付けした教師あり学習のようなものだ」と捉えること。さらに、その重みには報酬をそのまま使うのではなく、何かしらの基準値との差を使うこと。
このあたりが腑に落ちていると、新しいアルゴリズムに触れたときにも、何を工夫しているのかが見えやすい。
考えてみれば、教科書は客観的な知識をまとめたもののように見えて、何を載せ、何を省き、どこに紙幅を割くかは、著者によってずいぶん違う。
言語学者が書く NLP の教科書と、LLM の開発者が書く教科書では、きっと違うものができるだろう。同じ分野について書いていても、それぞれが経験してきたことや、重要だと考えていることが違うからだ。
私は、こうした違いにも価値があるのではないかと思う。
もちろん、AI もさまざまな観点から情報を重み付けできる。人間の判断のほうが優れていると言いたいわけではない。
ただ、「この分野で10年間研究開発をしてきた一人が、何を重要だと思っているか」という情報そのものにも、学ぶ側にとって使い道があるはずだ。
学習データは一つじゃなくていい
ここまで考えると、人間の書く教科書、というか人間が情報をまとめるという行為が、AI に完全に取って代わられるという心配は杞憂だったように思う。
機械学習では、あるデータでうまく学習しても、未知のデータに対してうまく対応できるとは限らない。学習データの偏りによって、特定のパターンばかりを覚えてしまうことがある。さまざまな状況に対応できる、いわゆる汎化性能を高めるには、多様なデータに触れることが役に立つ。
人間の学習も、少し似ているのではないか。AI が自分の知識や興味に合わせて説明してくれるのはありがたい。ただ、自分にとってわかりやすい説明だけで学んでいると、別の角度から問われたときに、案外うまく説明できないこともあるだろう。
ならば、学習に使う情報源を一つに絞る必要はない。AI に自分向けの説明をしてもらう一方で、他人が独自の重み付けで書いた教科書も読んでみる。自分では重要だと思っていなかった話題に出会ったり、同じ概念について違う説明を読んだりする。
同じ事柄であっても、繰り返し多様な形で触れることで、応用の利く理解につながるはずだ。私が書いた本も、そんな学習データの一つとして役立ててもらえたら嬉しい。
というわけで、『イラストで学ぶ 自然言語処理』をよろしくお願いします。
わからないところは、LLM に聞きながら読んでください。
イラストで学ぶ 自然言語処理 大規模言語モデルへの最短コースAmazon.co.jp
Footnotes
-
この章は、この道のプロである藤井一喜氏の助言をいただいて執筆した。この場で改めて謝意を表したい。 ↩